1
 한화금융 신사업 AI, 데이터 직무 지원
강호승
hoseunggg@gmail.com
github.com/hoseunggg
Suwon, KR
github.com/hoseunggg
Suwon, KR
Profile
Experience
소프트웨어 마에스트로 17기 연수생2026 — Present
Education
성균관대학교
기계공학, 경제학, 소프트웨어학 전공2021 — 2026
기계공학, 경제학, 소프트웨어학 전공2021 — 2026
185학점, 평점 4.19/4.5, 우등졸업 (Magna Cum Laude)
Other experience
Activities
성균관대학교 프로그래밍 수업 TA2025 — 2026
SW 교육 등 자원봉사 295시간2021 - 2025
Qualifications
SQLD (2026), ADsP (2022)
Training
AWS ML Engineering, Generative AI (2026)
Google AI Fundamentals (2026)
Achievements
Publications
Bitcoin forecasting with machine learning and on-chain information
제1저자, Investment Analysts Journal (SSCI), 2026
A Study of Optimization Algorithms for ASR Model Training
ASK 2026 학술발표대회 논문집 · KIPS
Honors
대통령과학장학생2025
정보통신기획평가원장상2022
세아해암학술장학재단 제30기 장학생2022
Skills
ML / AI
PyTorch, Scikit-learn, XGBoost
Data
SQL, pandas, NumPy, ETL 파이프라인
LLM Serving
vLLM, FastAPI, Docker, AWS, JSON-LD
Languages
Python, C, C++, SQL
2
Project 01
searchON GEO 최적화 서비스
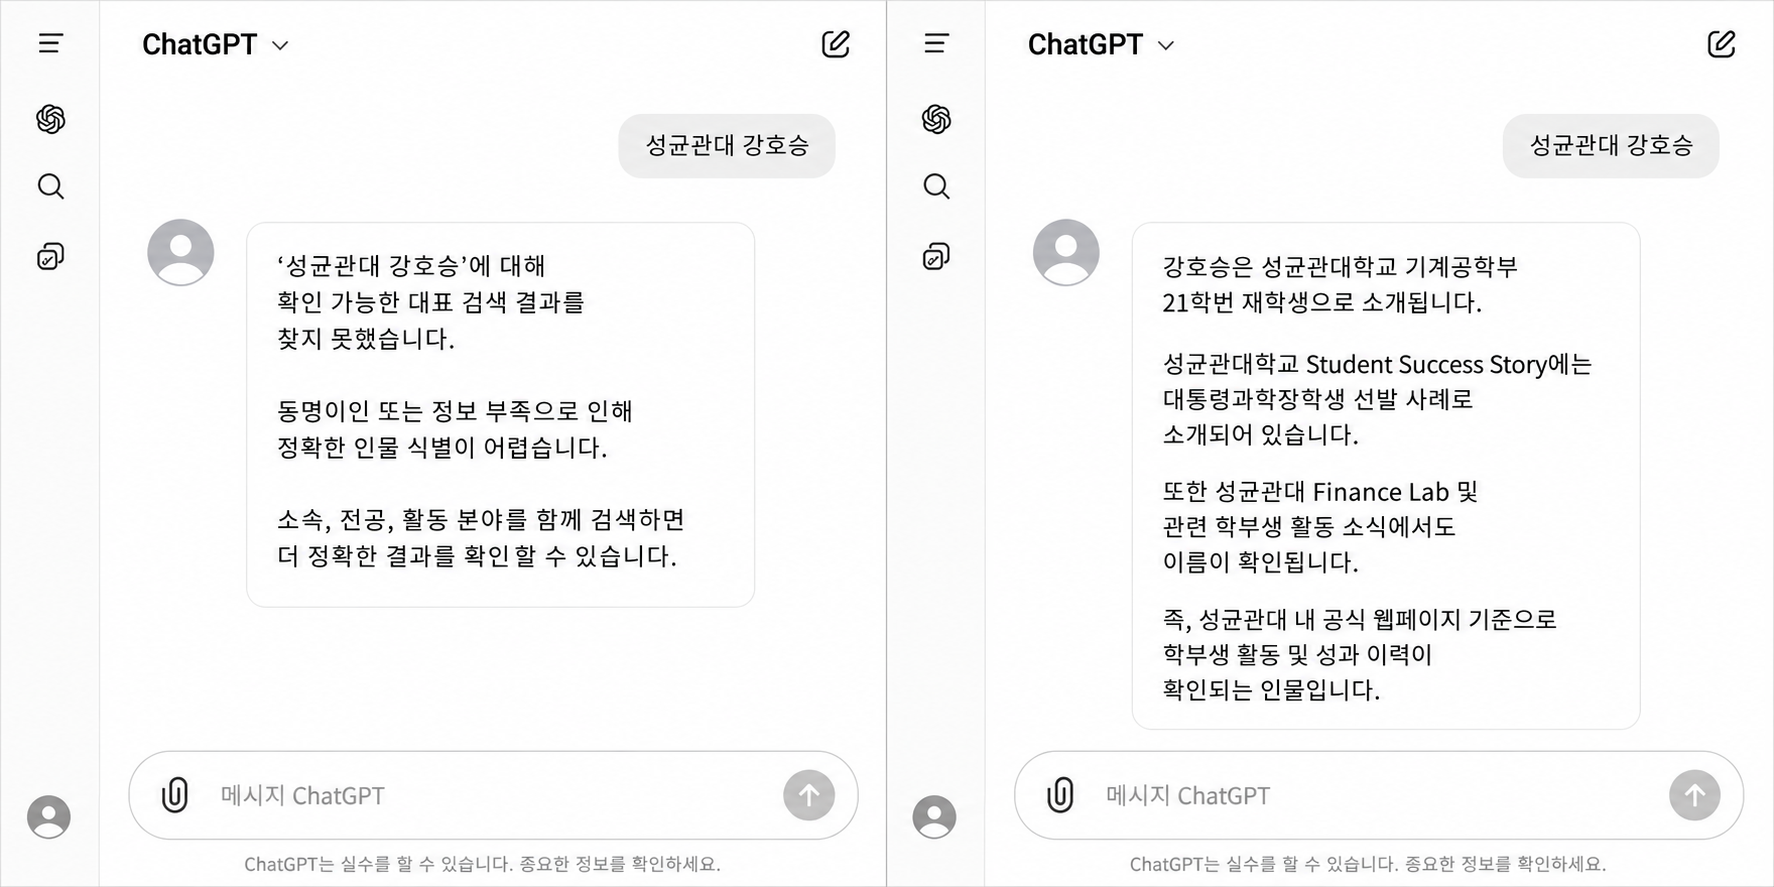
웹페이지가 ChatGPT 등 생성형 AI 답변에서 더 잘 인용되도록 돕는 GEO 최적화 서비스
Background
생성형 엔진 최적화(GEO, Generative Engine Optimization)는 ChatGPT, Gemini, Perplexity와 같은 생성형 AI 검색 엔진이 웹 콘텐츠를 발견·이해하고 답변에서 인용하도록 최적화하는 기술입니다. 본 프로젝트는 웹페이지의 구조와 콘텐츠를 분석해 생성형 AI 검색 환경에서의 발견 및 인용 가능성을 진단하고, GEO 관점의 최적화 방향을 제공하는 서비스입니다.
(Left) GEO 적용 전 검색 화면 / (Right) GEO 적용 후 검색 화면
3
Project 01
searchON GEO 최적화 서비스
LLM Inference Pipeline
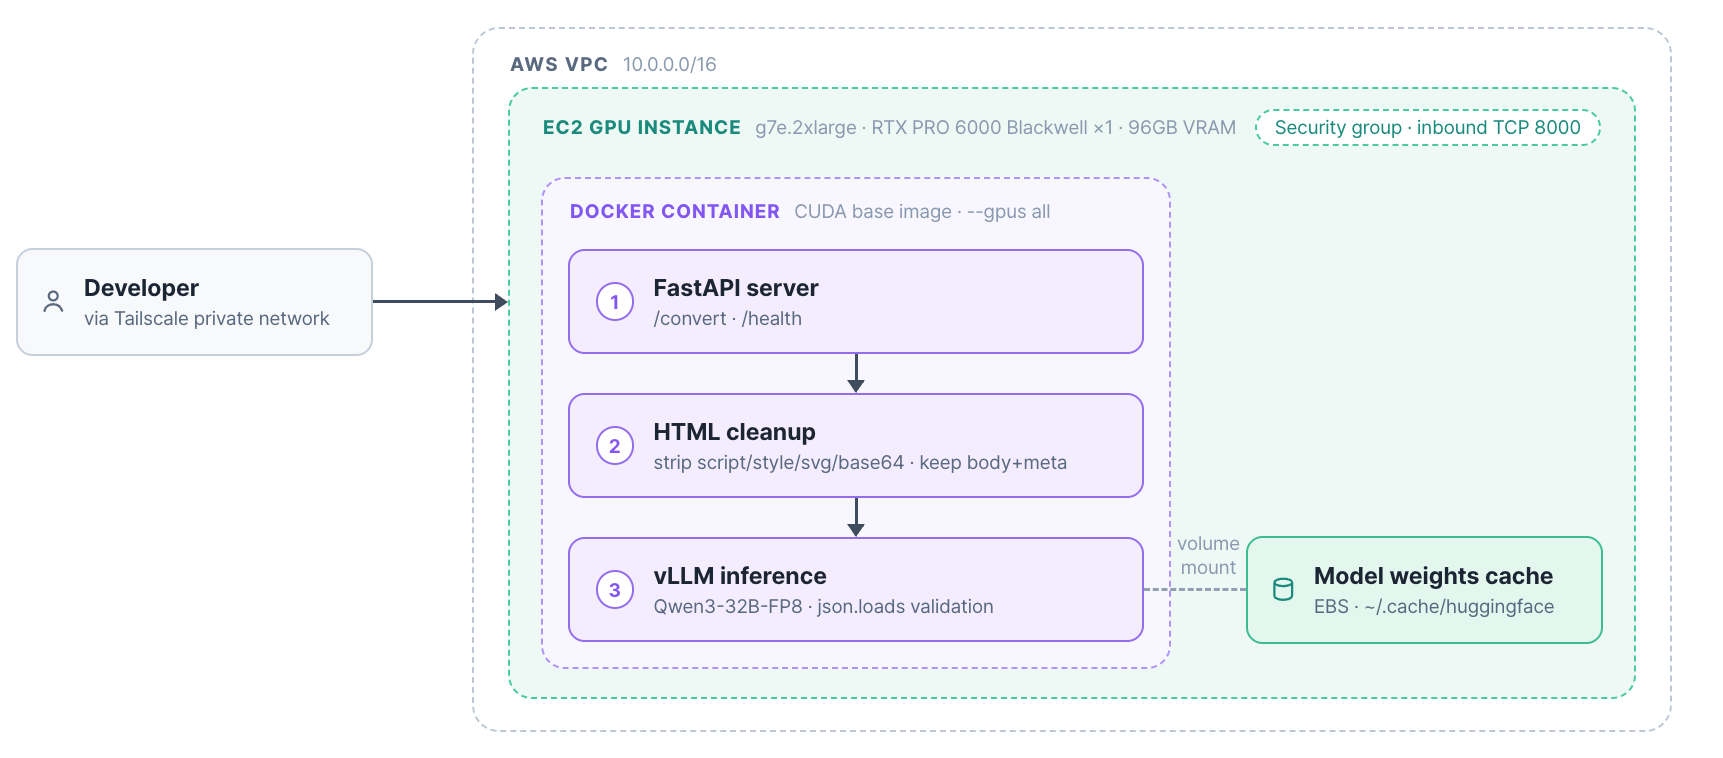
AI Pipeline
HTML 정제 파이프라인을 통해 웹페이지의 노이즈를 제거하고, 정제된 콘텐츠를 gemma-4-31B 기반 vLLM 추론 서버에서 분석하여 JSON-LD를 생성했습니다. FastAPI와 Docker로 추론 API를 서비스화하고, GPU 인스턴스와 EBS 모델 캐시를 활용해 모델 로딩 및 재배포 효율을 개선했습니다.
4
Project 01
searchON GEO 최적화 서비스
My contribution
Serving and MLOps
AWS GPU 인스턴스에 vLLM 추론 서버를 구축하고 오픈 웨이트 모델 서빙 환경을 운영했습니다. 모델 서버와 API 서버를 분리해 API를 재배포해도 모델을 다시 적재하지 않도록 했고, 모델 가중치와 Hugging Face 캐시는 EBS 볼륨에 두어 인스턴스를 교체해도 재다운로드가 없게 했습니다. 더 큰 VRAM이 필요해지자 초기 CUDA 컨테이너 구성에서 출발해 애플리케이션 수정 없이 상위 GPU 인스턴스로 추론 환경을 이전했고, 현재는 모델 서버와 API를 각각 systemd 유닛으로 운영하며 배포 파이프라인이 서비스 재시작까지 처리합니다.
Model Evaluation
gemma-4-31B, gpt-oss-120b, Llama-3.3-70B, Qwen3.5, EXAONE-4.5 등 5개 오픈 웨이트 모델을 동일 조건으로 비교했습니다. 8개 사이트에서 모은 상세페이지 39장으로 정답셋을 직접 만들고, 모델명을 가린 블라인드 설계로 판정 192건을 수행했습니다. 처음에는 문자열 비교로 채점했는데 380 kcal과 380 calories를 서로 다른 값으로 세어 환각을 약 10배 과대계상하는 것을 발견하고, 판정 자체를 LLM 채점으로 바꿔 평가 지표를 다시 설계했습니다. 정확도 99.1%(모델과 사이트가 모두 값을 낸 필드 기준, F1 0.601, 재현율 43.2%), 환각 0건, VRAM 33GB, 자기 불일치 0%를 종합해 gemma-4-31B-FP8을 선정했습니다. gpt-oss-120b는 2.4배 빨랐지만 같은 입력을 두 번 넣었을 때 출력의 56.9%가 달라져 재현성을 이유로 기본 선택에서 탈락시켰습니다.
Output Control
JSON-LD에 원문에 없는 URL이 들어가는 문제가 있었습니다. 모델을 바꿔도 재현되길래 입력을 추적해보니 원인은 모델이 아니라 정제기였습니다. HTML 정제 단계에서 유지 속성 목록에 href가 빠져 있어 모델이 볼 수 있던 URL 497개 중 198개, 약 40%가 사라졌고 모델이 그 빈자리를 지어내고 있었습니다. 속성 유지 규칙을 고쳐 입력에서 근거를 되살렸습니다. 입력 단계에서는 script, style, base64와 불필요한 UI 요소를 제거하는 HTML 클렌징 파이프라인으로 메인 페이지 43장 기준 입력을 91.5% 축소하면서 핵심 사실은 99.9% 보존했고, 출력 단계에서는 json.loads 기반 구문 검증으로 파싱에 실패한 응답이 후속 파이프라인에 전달되지 않게 했습니다.
5
Project 02
Bitcoin Return Prediction
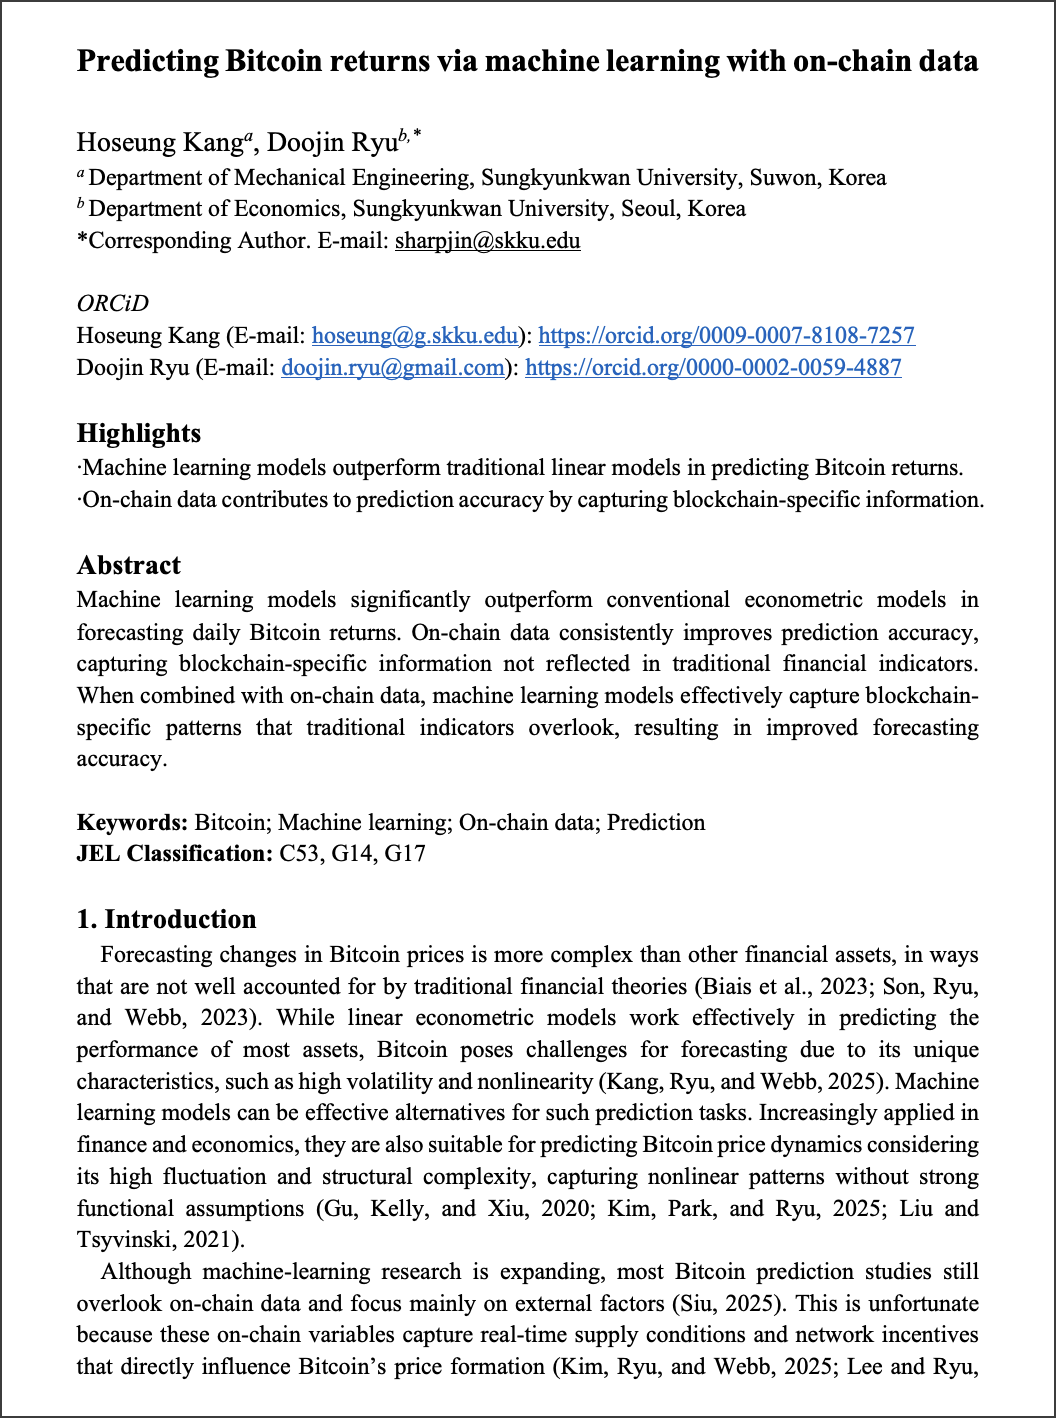
온체인 데이터와 머신러닝을 결합해 비트코인 수익률을 예측한 연구
논문 표지
Problem
비트코인은 변동성이 워낙 커서 전통적인 계량경제 모델로는 예측에 한계가 있습니다. 또한 가격 형성의 단서는 오히려 온체인 데이터에 담겨 있지만, 기존 연구들은 외부 요인에만 집중하느라 이를 제대로 활용하지 못했습니다. 그래서 온체인 데이터를 피처로 통합한 머신러닝 모델이 예측 성능을 실제로 끌어올리는지 검증하고자 했습니다.
Approach
2017년 1월부터 2023년 12월까지의 일별 데이터로 온체인 피처를 설계하고 금리 같은 거시 지표와 결합했습니다. AR부터 RF, XGBoost, SVM, MLP까지 5개 모델의 학습과 평가 파이프라인을 동일 조건으로 구현했습니다. 그리드 서치로 하이퍼파라미터를 튜닝한 뒤 365, 450, 540, 630, 730일 5종의 롤링 윈도우에서 one-step-ahead 예측을 수행해 look-ahead bias를 차단했습니다.
Result
전체 표본 기준 랜덤포레스트와 SVM의 RMSE가 0.033~0.035로 AR의 0.042~0.046보다 낮았습니다. 다만 저변동성 구간에서는 두 모델과 AR의 차이가 거의 없었고, 개선폭은 구간에 따라 19~25%, 고변동성 구간에서 최대 약 29%였습니다. 변수 기여도는 PFI와 SHAP 두 방법으로 교차검증해 온체인 변수가 전체 중요도의 약 절반(PFI 기준 RF 49.5%, SVM 51.1%)을 차지한다는 점을 보였습니다. 이 결과는 Investment Analysts Journal(SSCI)에 제1저자 논문으로 게재됐습니다.
6
Project 02
Bitcoin Return Prediction
My contribution
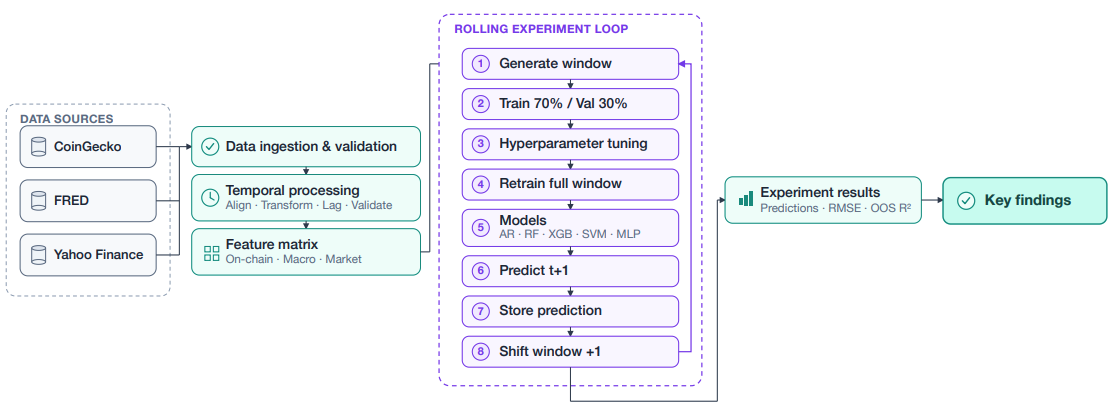
Pipeline
CoinGecko, FRED, Yahoo Finance에서 온체인, 거시, 시장 데이터를 수집해 검증, 시계열 정렬을 거쳐 피처 매트릭스를 구성했습니다. 예측은 롤링 윈도우 루프로 자동화했습니다. 윈도우마다 학습 70%, 검증 30% 분할로 하이퍼파라미터를 튜닝하고, 전체 구간으로 재학습해 다음날 수익률을 예측한 뒤 윈도우를 하루씩 밀며 반복하는 구조입니다. 이 파이프라인 위에서 AR, RF, XGBoost, SVM, MLP 5개 모델을 동일 조건으로 비교하고, RMSE와 OOS R²로 평가했습니다.
7
Project 02
Bitcoin Return Prediction
Data Pipeline
Fixing Data Gaps
비트코인은 24/7 거래되지만 S&P 500, 국채 금리 같은 전통 자산은 주말·휴일 데이터가 비어 있습니다. 이 때문에 CoinGecko, FRED, Yahoo Finance 세 소스의 날짜 인덱스가 서로 어긋났습니다. 공통 캘린더 기준으로 인덱스를 통일한 뒤, 결측값은 forward fill로 처리했습니다. 미래 값을 참조하는 방식은 look-ahead bias가 생기기 때문에 배제했습니다. 이 전처리를 거치면 거래일 체계가 다른 데이터도 Rolling Window 파이프라인에 그대로 태울 수 있습니다.
Speeding Up Experiments
모델 5개 × Window 크기 × 하이퍼파라미터 조합이라 실험 한 사이클에 수 시간이 걸렸습니다. 각 (모델, Window) 학습 작업은 서로 의존성이 없어서, Python multiprocessing으로 작업을 워커에 분배하는 병렬 구조로 전환했습니다. 그 결과 모델 비교와 하이퍼파라미터 탐색 사이클을 크게 단축할 수 있었습니다.
Checkpoint & Recovery
Rolling Window 실험은 러닝타임이 길어서 OOM이나 환경 문제로 중간에 죽으면 전부 재실행해야 했습니다. 그래서 Window 단위로 예측 결과, 평가 지표, 하이퍼파라미터를 CSV에 저장하는 체크포인트를 넣었습니다. 재시작 시 기존 결과 파일을 스캔해 완료된 Window는 스킵하고 남은 작업만 이어서 실행합니다. 중단이 발생해도 완료분은 그대로 재사용되므로 실험을 처음부터 다시 돌릴 일이 없어졌습니다.
8
Project 03
Shapley Sector Portfolio
협조게임 이론으로 섹터별 포트폴리오 기여도를 정량화한 연구
Problem
현대 포트폴리오 이론은 전체 위험을 최소화하는 최적 조합은 제시하지만, 그 위험 감소가 어느 섹터의 협력으로 만들어졌는지는 설명하지 못합니다. 단순 비중이나 상관계수로는 누가 더 기여했는가를 가려낼 수 없습니다. 그래서 섹터 및 산업 ETF 11종을 협력 게임의 플레이어로 두고, 협력으로 만든 위험 감소분을 각 섹터에 공정하게 배분하는 문제로 재정의했습니다.
Approach
공매도 금지, 레버리지 없음, 평균-분산이라는 세 가정 위에서 두 가치함수를 정의했습니다. 위험 감소는 개별 분산의 합에서 최소분산 포트폴리오의 분산을 뺀 값, 효용은 평균-분산 효용의 최댓값으로 두었습니다. 11종이 모두 거래된 2018년 7월부터 2025년 11월까지 89개월의 월별 수익률을 쓰고, 완전 계산이 필요한 2047개 연합 대신 몬테카를로 순열 샘플링으로 각 섹터의 Shapley 값을 근사했습니다.
Result
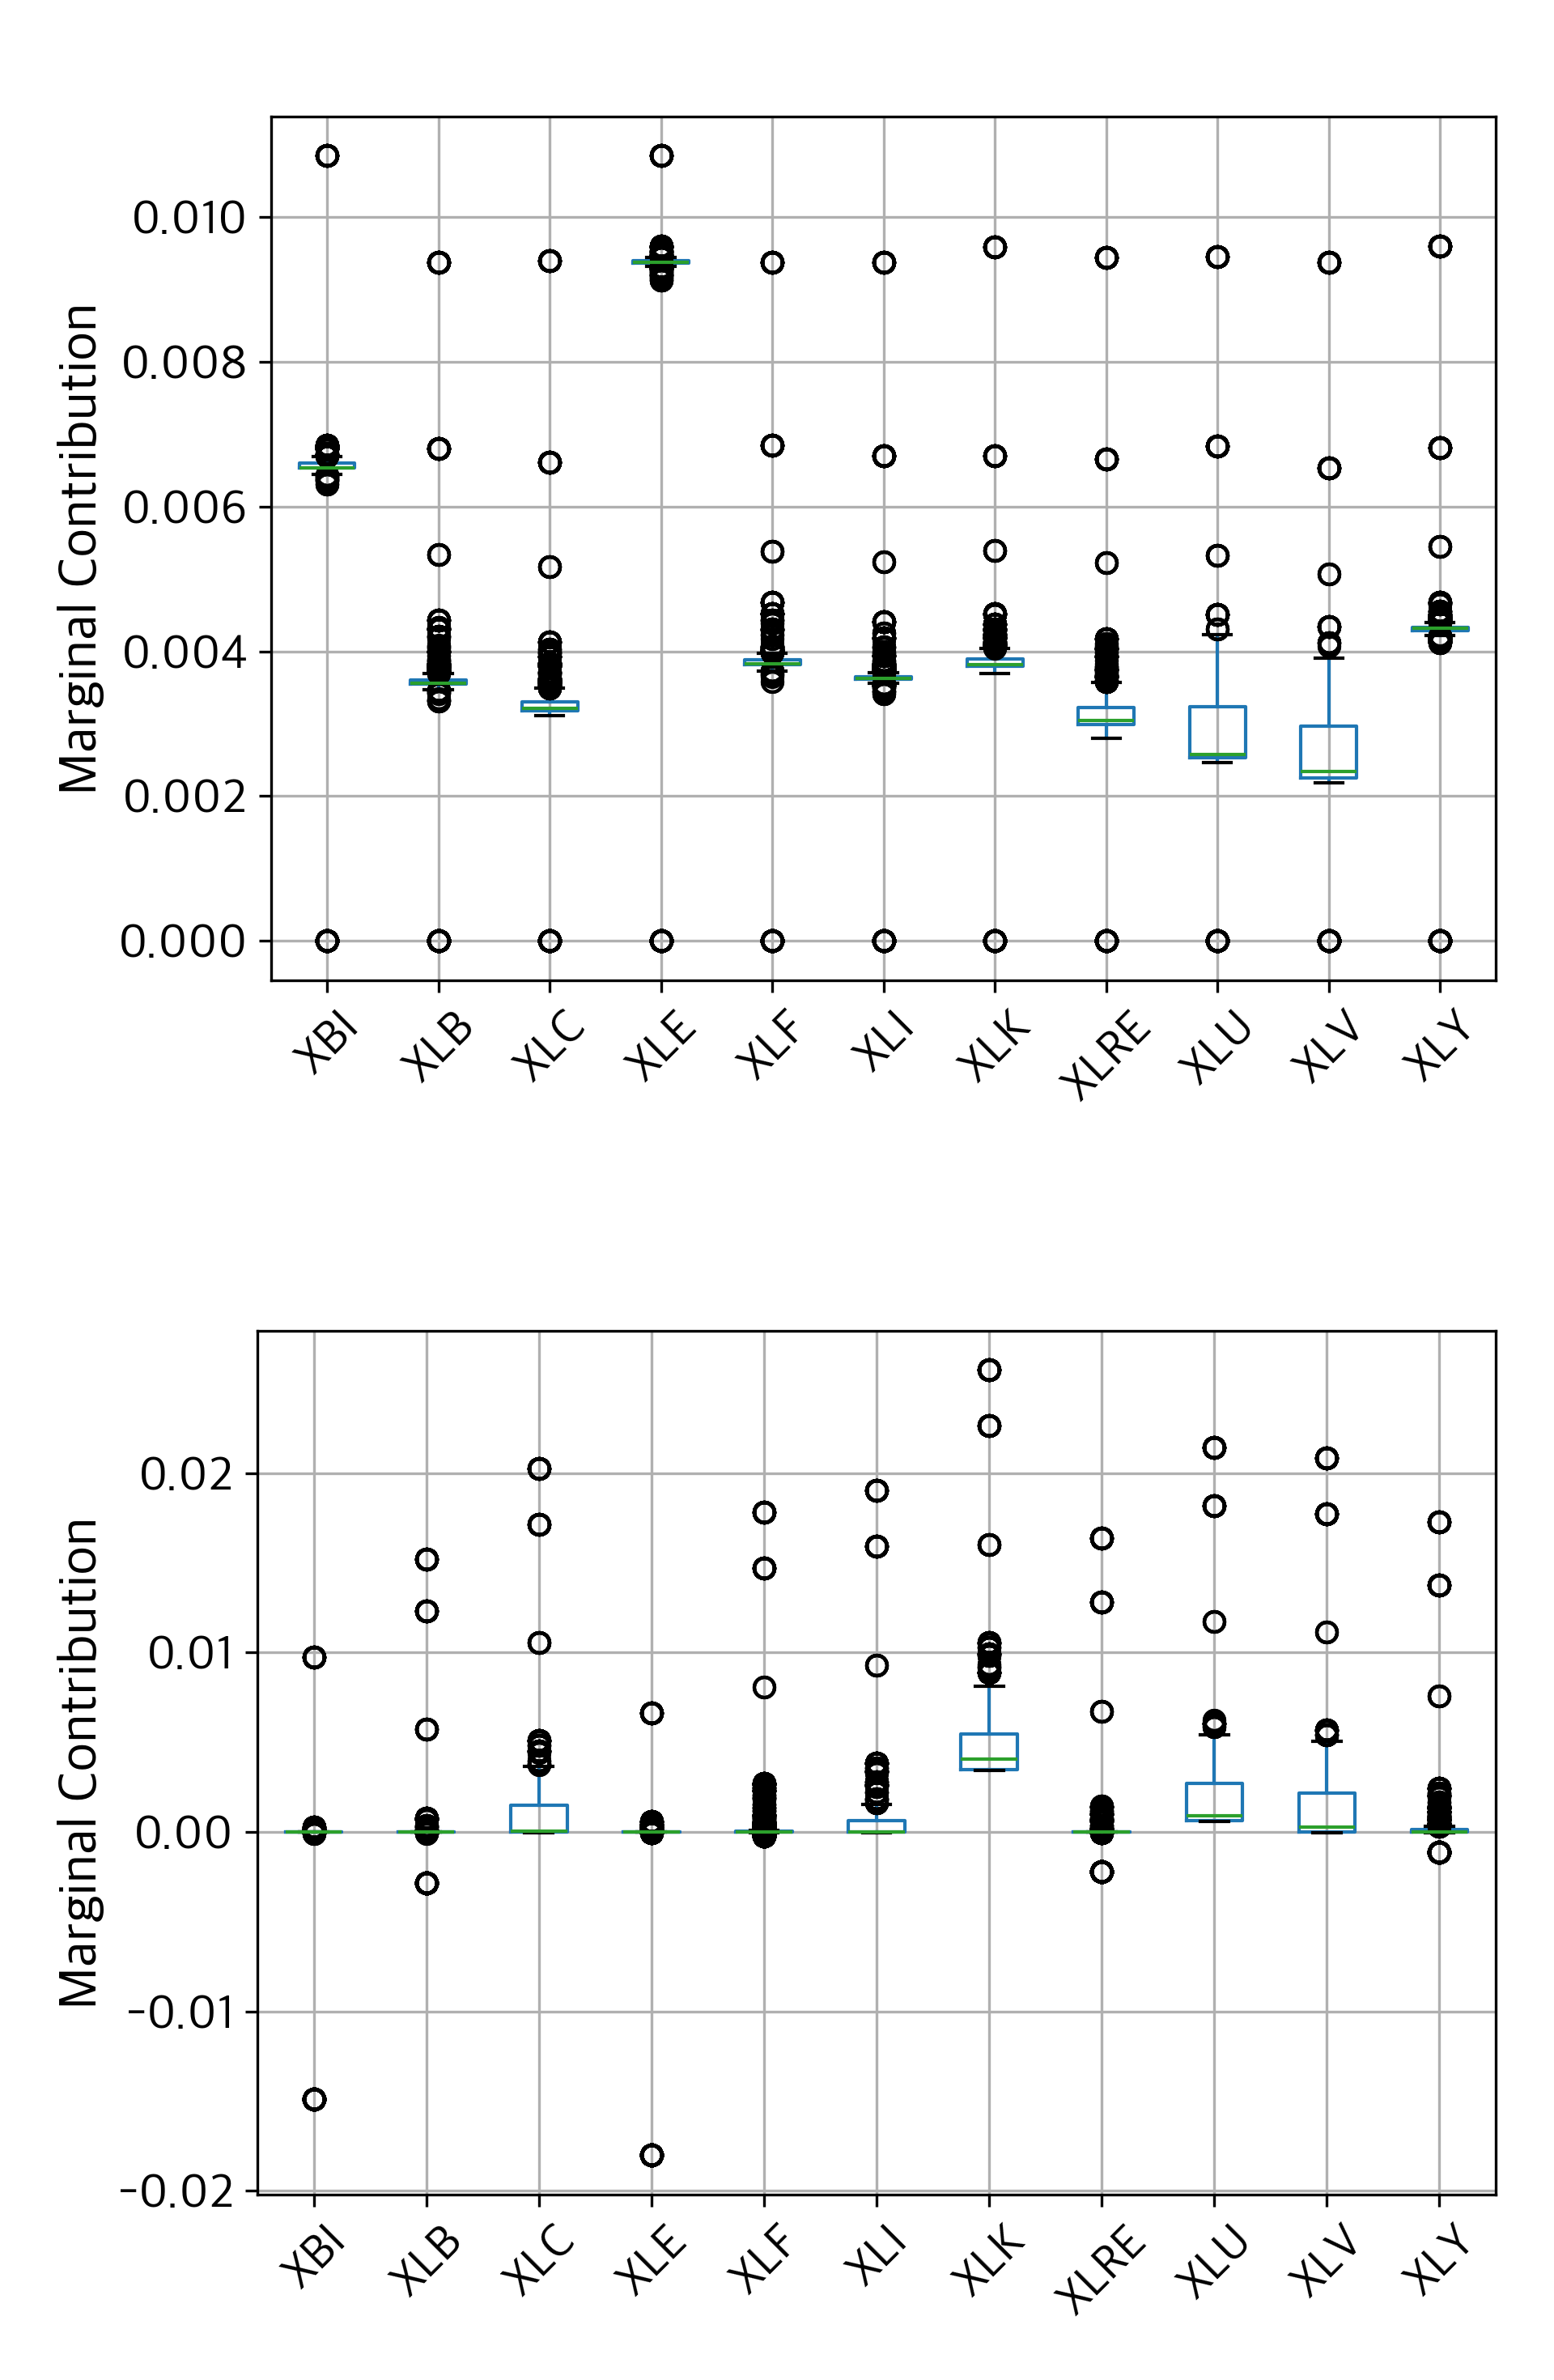
위험 감소 기준에서는 에너지(XLE)와 바이오테크(XBI)의 Shapley 값이 가장 높아 포트폴리오 분산 축소를 주도했고, 효용 기준에서는 정보기술(XLK)과 유틸리티(XLU)가 앞섰습니다. 특히 XLE는 위험 감소 기여가 가장 큰 반면 평균 Shapley 값 기준 효용 기여는 음수로 나타나, 위험 완화형 섹터와 효용 중심 섹터가 구조적으로 구분된다는 점을 정량적으로 보였습니다.
(위) 위험 감소 기여 / (아래) 평균-분산 효용 기여
9
Project 03
Shapley Sector Portfolio
Shapley Value Approximation
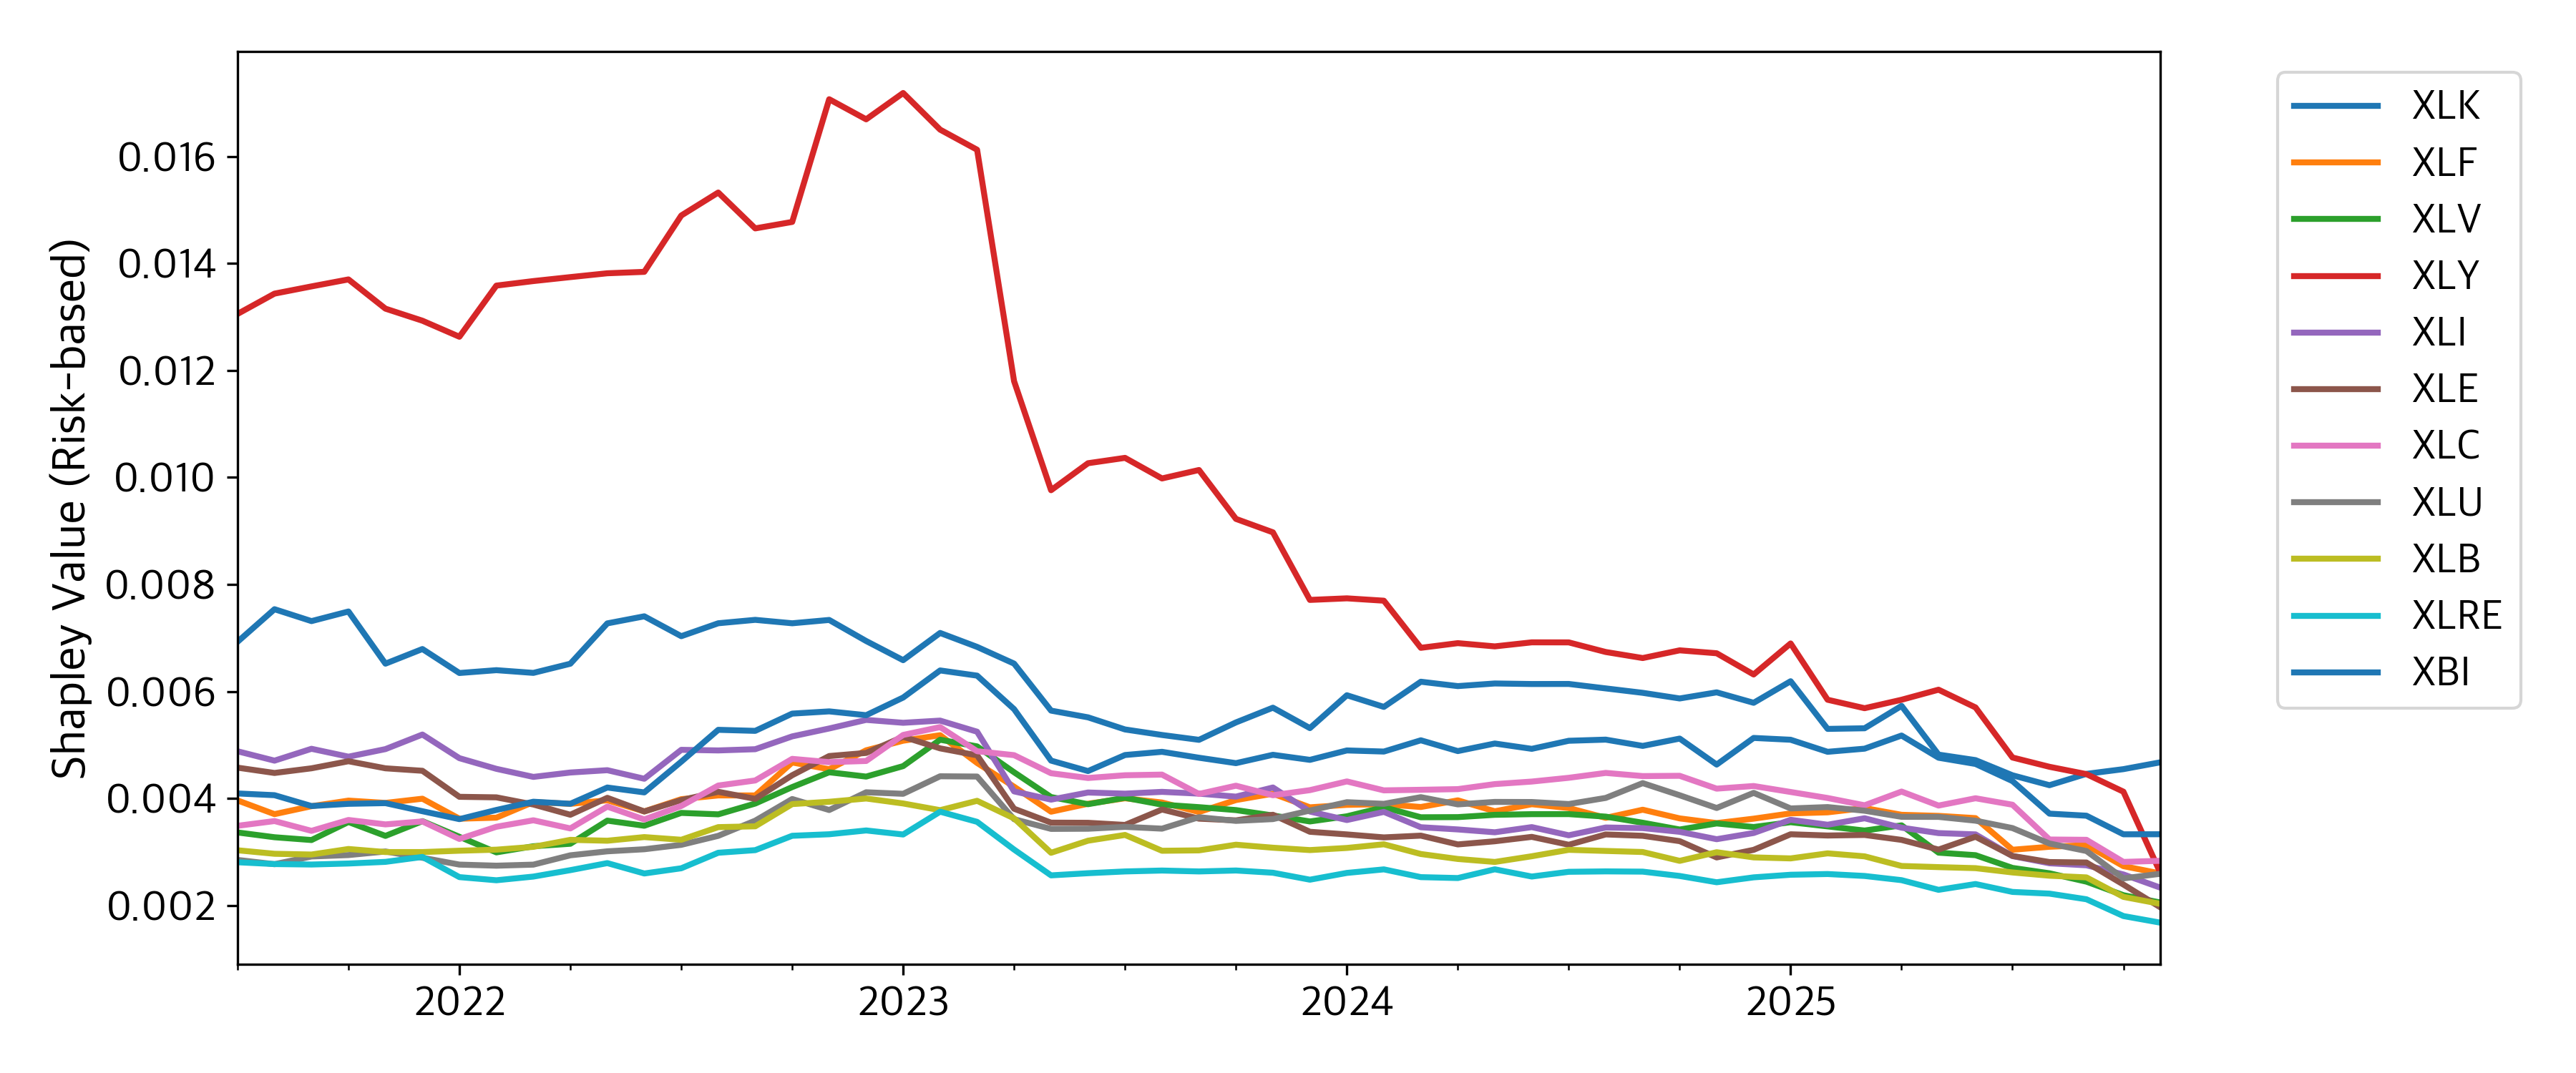
롤링 Shapley 값, 시간에 따른 섹터별 위험 감소 기여
Pipeline
Yahoo Finance에서 11종 ETF의 월별 수정종가를 받아 수익률과 공분산 행렬을 만든 뒤, 연합마다 두 가치함수를 계산했습니다. Shapley 값은 정의식을 순열 기대값 형태로 바꿔 무작위 순열에서 각 섹터가 합류하는 순간의 한계 기여를 평균내 근사했고, 표본 간 독립성을 살려 joblib으로 병렬 처리했습니다. 전체 표본은 순열 3,000회, 36개월 롤링 윈도우는 시점마다 300회를 뽑아 추정값이 수렴하도록 했고, 롤링으로 기여도의 시계열 변화를 추적했습니다.
10
Project 03
Shapley Sector Portfolio
Method Details
Value Function Design
하나의 지표로는 포트폴리오 기여를 온전히 설명하기 어려워 위험과 효용, 두 축으로 가치함수를 나눴습니다. 위험 축은 개별 분산의 합 대비 최소분산 포트폴리오가 분산을 얼마나 줄이는지로 정의했고, 부록에서 한 섹터에 100% 투자하는 경우가 상한이 되어 이 값이 항상 0 이상임을 증명했습니다. 효용 축은 위험회피 계수를 반영한 평균-분산 효용의 최댓값으로 두어, 위험을 줄이는 섹터와 효용을 끌어올리는 섹터를 분리해 볼 수 있게 했습니다. 두 최적화 모두 공매도 금지와 비중 합 1 제약 아래 SLSQP로 풀었습니다.
Monte Carlo Approximation
플레이어가 11개면 완전 계산에 2047개 연합이 필요하고 복잡도가 지수적으로 폭증합니다. 그래서 Shapley 값을 순열 기대값으로 재정의하고 무작위 순열을 표본 추출해 한계 기여의 평균으로 근사했습니다. 표본이 서로 독립이라 병렬화가 쉽고, 완전 계산보다 비용이 훨씬 낮으면서도 편향 없는 추정치를 얻었습니다.
Dynamic Analysis
정적 평균만으로는 시장 국면 변화를 담기 어려워 36개월 롤링 Shapley 값으로 시계열을 추적했습니다. 위험 감소 기준에서는 표본 대부분의 구간에서 소비재(XLY)와 바이오테크(XBI)가 높은 기여를 유지했고, 효용 기준에서는 헬스케어(XLV)의 기여가 표본 후반부에 뚜렷이 상승했습니다. 시기별로 주도 섹터가 달라진다는 점에서, 시장 환경 변화가 협력적 기여 구조에 실제로 영향을 준다는 것을 확인했습니다.